批量删除PDF中的身份证号,大量文档一键脱敏,3步完成
批量删除PDF中的身份证号,难点通常不在删除动作本身,而在于文档数量大、信息分散、人工核对耗时长。本文围绕大量文档一键脱敏这个需求,介绍一种更省事的处理方法:利用鹰迅批量处理工具箱中的规则修改功能,通过正则模糊查找统一识别身份证号码,再批量删除或替换。整个过程支持离线处理,不需要把文件上传到外部平台,适合资料归档、对外发送前清理、内部共享脱敏、审查材料预处理等场景。对于经常处理多份PDF的人来说,这套流程更容易兼顾效率、准确性和隐私安全。
一、先确认:你的目标是删除身份证号,而不是仅做遮挡吗?
- 如果只是截图演示,做视觉遮挡可能够用;但要用于资料分发、共享或留存,直接批量删除身份证号会更干净。
- 当文档数量很多、页数又杂时,手动查找删除很容易漏掉,这时更适合用规则匹配方式一次处理。
二、批量脱敏方式对比:为什么本地规则删除更高效
- 在线工具的问题主要在于文件上传、等待和敏感内容外传顾虑,不少人处理证件信息时都会避开这类方式。
- 本地规则处理更适合大量文档,一次导入、一套规则、一键输出,操作简单,重复任务也方便复用。
- 对需要快速脱敏又要保留文档版式的用户来说,这种方式更符合日常办公需求。
三、批量删除PDF身份证号效果预览
处理前效果

处理后效果

删除完成后,文档中的身份证号码可被统一清除,方便继续存档、传递或对外使用。
四、实操教程:3步完成批量删除PDF中的身份证号
步骤1:进入PDF内容规则修改界面
打开软件后,在左侧选择「PDF 工具」,然后在右侧点选第一个功能「按规则修改 PDF 内容」。删除身份证号就从这里开始。

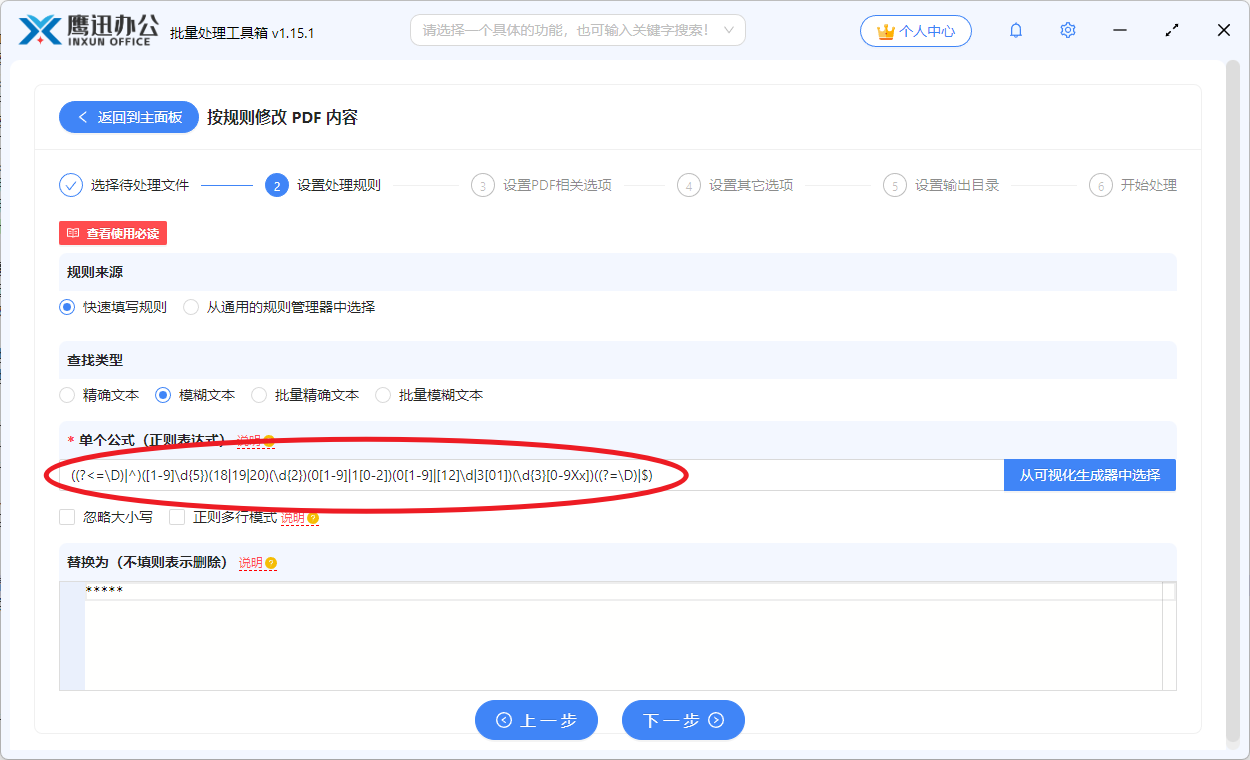
步骤2:添加文件并设置身份证号删除规则
先把所有需要脱敏的PDF加进来,然后在查找方式中选择模糊文本。因为身份证号每份文档都不同,用正则匹配更稳妥。工具支持精确文本、模糊文本、批量精确文本、批量模糊文本四种查找方式,本场景选择模糊文本更合适。
「单个公式」输入:((?<=\D)|^)([1-9]\d{5})(18|19|20)(\d{2})(0[1-9]|1[0-2])(0[1-9]|[12]\d|3[01])(\d{3}[0-9Xx])((?=\D)|$);「替换为」保持空白即可,空白代表找到后直接删除。要是你想保留痕迹便于复核,也可以改成星号形式。
这一组设置完成后,等于已经把“查什么”和“怎么处理”一次交代清楚了,后面的批量执行就会顺很多。
步骤3:设置输出目录并完成批量脱敏
设置好输出目录后直接开始处理。完成后打开结果文件夹检查几份文件,看身份证号是否都已删除干净,没问题就可以继续后续使用。


五、批量删除身份证号最容易遇到的5个坑
- 以为手动搜索就够,结果同批文件格式不同,漏删不少。
- 正则输入时少了转义或括号,导致完全匹配不到。
- “替换为”误填了内容,结果不是删除而是改成别的字符。
- 没有单独设置输出目录,原始文件和结果文件混淆。
- 处理完成后不抽检,部分特殊页面问题没及时发现。
六、批量删除PDF身份证号的使用总结
本文解决的是大量PDF文档中身份证号码如何快速一键脱敏的问题。实际处理时,只需要进入按规则修改 PDF 内容功能,批量添加文件,选择模糊文本方式,输入身份证号正则,并把“替换为”留空,就能实现统一删除。再配合输出目录设置和处理后抽查,整套流程既不复杂,也更适合反复执行。对于需要做资料共享、对外交付、归档整理、审查预处理的人来说,这种本地批量删除方式会比手工逐页清理更省时。如果你最近正要处理一批带身份证号的PDF,可以先拿几份测试,确认没问题后再批量运行。