大量PDF清除指定字符内容,规则批处理更方便
大量PDF清除指定字符内容,规则批处理更方便,适合处理制度文件、说明文档、历史资料和统一修订类办公任务。很多PDF里会反复出现某些指定字符、旧称呼、无效标识或固定短语,手动逐份清理会比较费时间。借助鹰迅批量处理工具箱,可以按规则批量删除或替换这些字符内容,支持精确查找、模糊匹配和结果高亮,能更轻松地完成大量文档中的统一文本清理与核对工作。
适用场景:大量PDF中统一清除指定字符内容
当指定字符或固定短语在很多PDF里反复出现时,批量清理会比手动处理省力得多。像旧部门简称、历史标识、重复短语、无效字符、统一备注中的某段内容,都可以归到这一类。只要内容足够明确,按规则处理的效率就会很高。
- 制度文件修整:清除无效称呼、旧版简称或固定字符。
- 历史资料清洗:去掉重复标识和不再使用的短语。
- 通知说明修订:统一删除旧词或指定字符内容。
- 项目文档整理:批量清理反复出现的旧内容。
- 归档前优化:让批量文件内容更整洁规范。
方案核心优势介绍
- 规则化批处理适合大量PDF统一清理指定字符
- 支持删除或替换,方便完成不同修订任务
- 可选择精确文本或模糊文本,处理范围更灵活
- 支持结果高亮显示,核对更直观
- 适合高频重复的文本清理工作
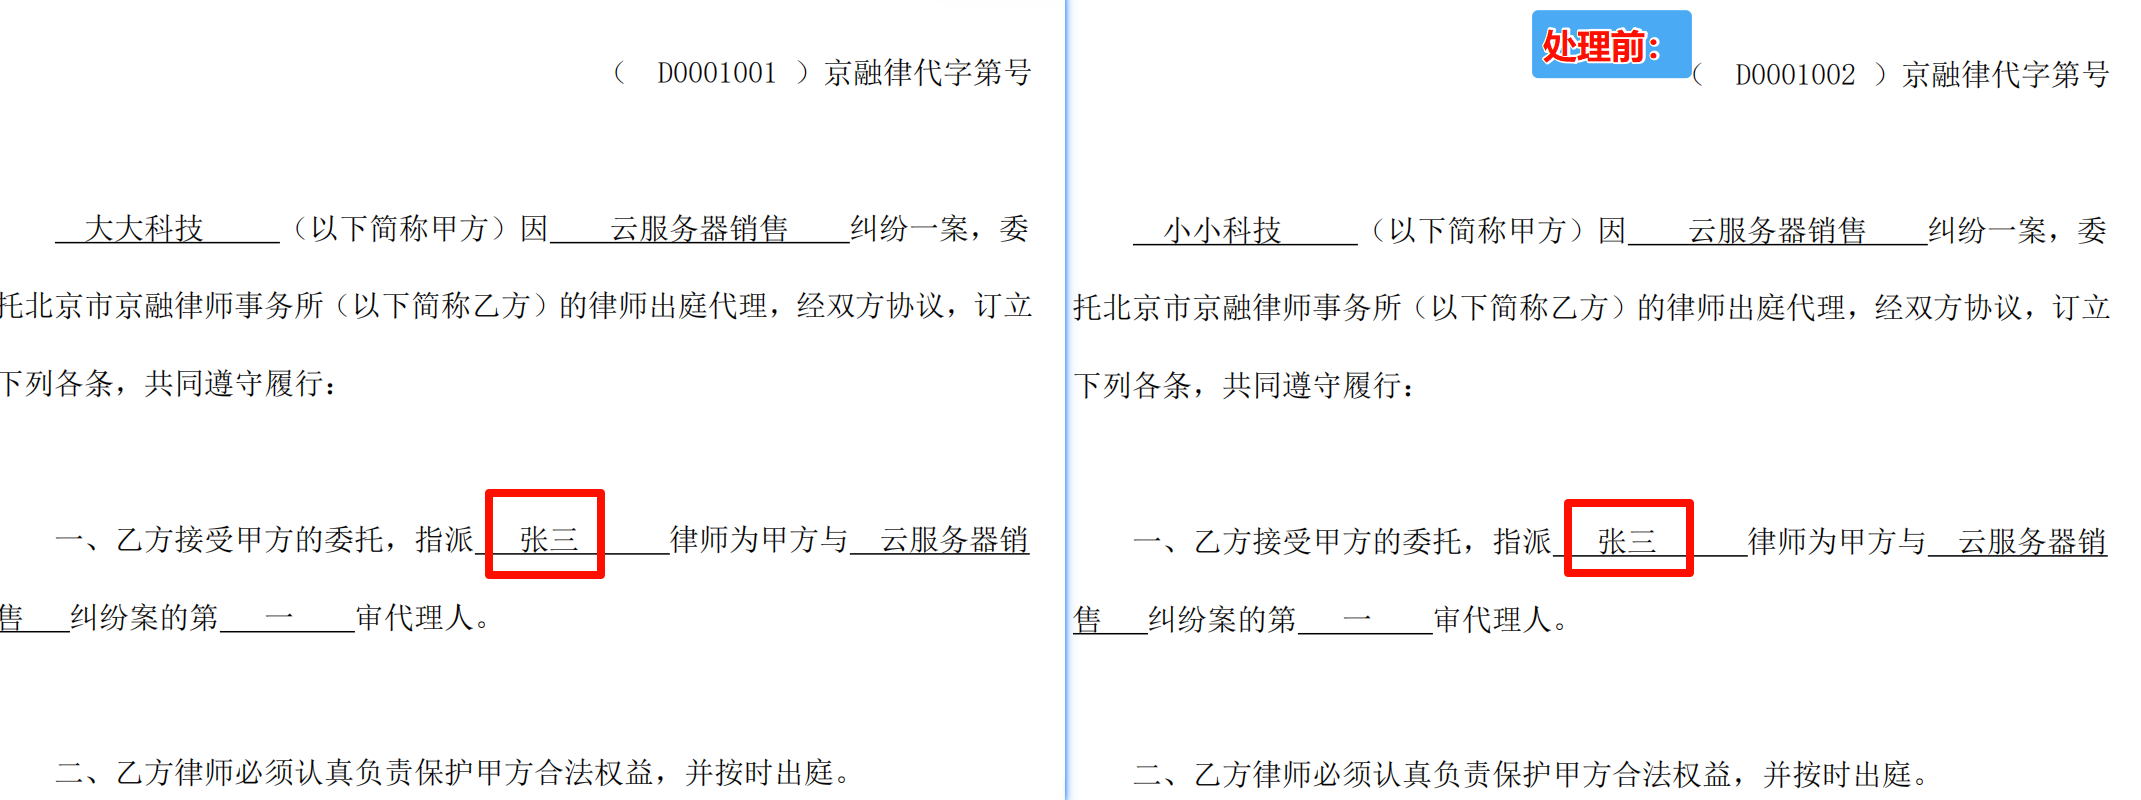
效果展示:指定字符内容清除前后效果
处理前效果
处理后效果
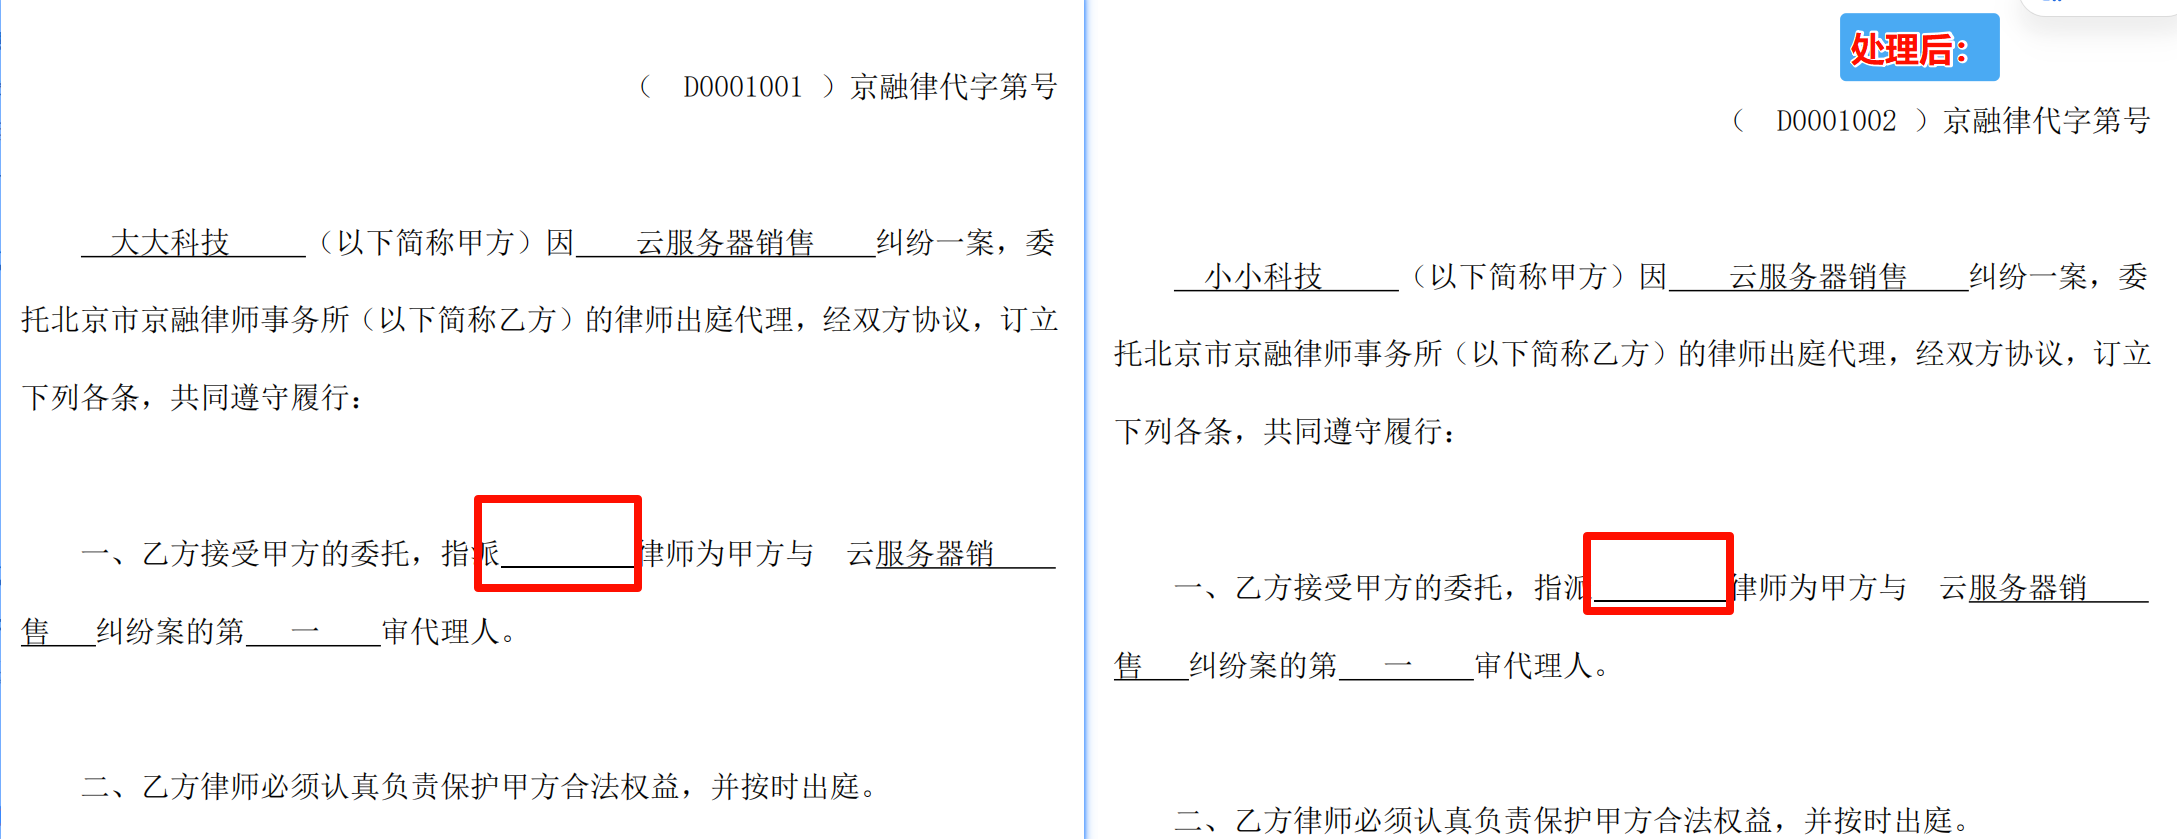
处理后,指定字符内容会按设定规则被集中清理掉,适合大批量文档的统一规范化。
操作步骤:大量PDF清除指定字符内容
第一步:打开PDF按规则修改内容功能
在软件主界面左侧选择「PDF 工具」,右侧点击第一个功能「按规则修改 PDF 内容」,进入文本规则处理页面。

第二步:导入大量需要处理的PDF文档
把待处理文件批量导入列表中,导入后先检查一遍文件数量和名称。大量文件操作时,这一步能帮你避免漏处理或者多处理。

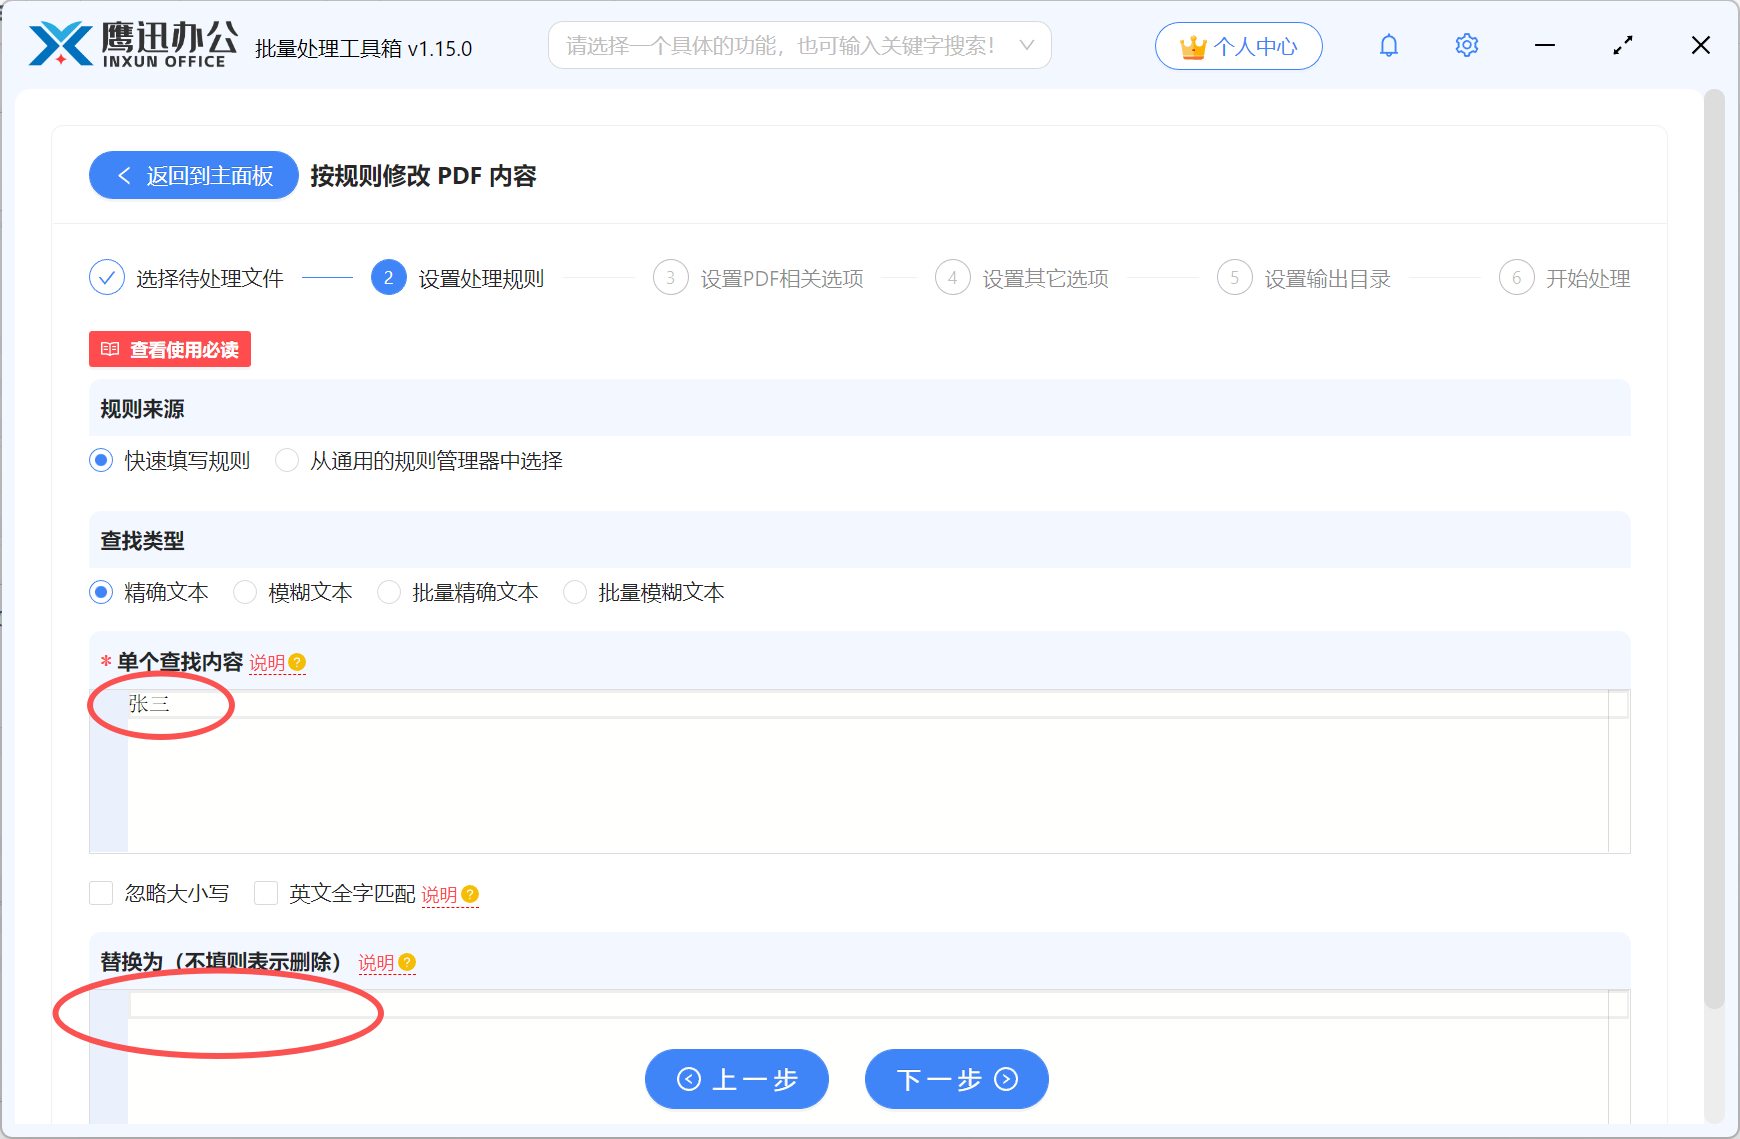
第三步:选择精确文本设置字符清理规则
如果指定字符内容是固定不变的,直接使用精确文本会比较稳。在「单个查找内容」中输入原始字符或短语,「替换为」留空就可以删除;如果只是想统一改成新的写法,也可以填写替换内容。这个方法很适合大量文件中一致性很高的字符清理任务。
第四步:设置结果文件输出位置
建议将处理结果保存在新的目录中,后续查看效果、分类保存或回溯原文件时都会更方便。

第五步:等待批量处理完成并抽样检查
执行后,工具会依次处理列表中的PDF。完成后可以随机查看几份结果文件,确认指定字符内容是否已经清除。

小结:指定字符内容清理,规则批处理会更轻松
大量PDF中的指定字符清理,看起来是小事,但一旦文档数量上来,重复操作会非常耗时间。把这类问题交给规则批处理,不仅更省事,也更利于保持整批文件结果一致。建议先确认字符内容是否固定,再选择精确文本方式处理;如果遇到变化形式较多的内容,再考虑更灵活的匹配方式。处理前做样本测试,处理后做抽样检查,基本就能兼顾效率和稳妥性。